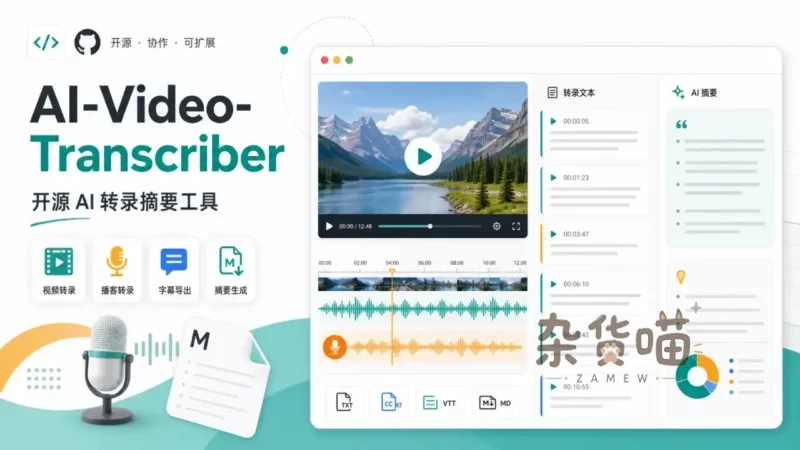

AI-Video-Transcriber 把视频、播客和本地录音整理成可下载的转录稿、翻译与摘要。它由 wendy7756 维护,采用 Apache-2.0 许可,提供自部署网页界面,也能通过命令行处理文件。想把课程、访谈或会议材料留成可检索的文字,它能串起提取字幕、语音识别和文本整理这几步。

使用前要分清两段处理:字幕提取或 Faster-Whisper 负责得到文字,OpenAI 兼容模型负责后续优化、翻译和摘要。自部署解决的是工具运行在哪里,文本是否发往外部仍取决于模型配置。
同样点“转录”,三种输入走的路不同
公开链接:先找字幕,找不到再识别音频
YouTube 等平台有可用字幕时,项目先提取字幕,无需为了得到文字再做完整语音识别;没有字幕才下载音频并调用 Faster-Whisper。界面的 Subtitle 或 Whisper 标记可以帮助判断当前走的是哪条路径。因此自带字幕的网课与纯口述无字幕录音,处理耗时与机器资源消耗差异显著,不宜拿字幕抓取的耗时估算全盘算力需求。
README 列出 YouTube、Bilibili、TikTok、Apple Podcasts、SoundCloud 等入口,底层下载依赖 yt-dlp。具体链接能否处理,还受平台访问规则、字幕可用性和网络影响。只处理有权访问和转录的材料;若链接本身要求登录后访问或有严格风控封锁,底层抓取工具依然可能下载失败。
本地音视频与已有文稿
本地 .mp3、.mp4、.wav、.mkv 等文件先经 FFmpeg 归一化,再做 Whisper 识别。上传 .txt 则直接进入文本整理,跳过下载和语音识别。已有会议逐字稿需要重新分段、翻译或提炼要点时,不必先把它转回音频。默认单文件上传上限为 200 MB,可通过 UPLOAD_MAX_MB 调整。
从原始材料到可保存的笔记
- 选择链接或本地文件,并设置摘要语言。如果只要文字,关闭默认开启的“保留原视频”,减少下载和磁盘占用。
- 展开 AI Settings,填写自己的 OpenAI 兼容 Base URL、API Key,获取模型列表后选择模型;也可以由部署者配置服务端默认值。
- 开始处理,观察任务进度。源语言与摘要语言不同的时候,会增加翻译结果;转录稿与摘要分别保留,便于对照。
- 下载需要的 Markdown 文件,抽查姓名、数字、日期和专业术语,再放入笔记或知识库。摘要只能辅助定位内容,引用关键结论仍应回到转录稿和原材料。
模型的“优化”可能补全句子和修正文字。采访、合同讨论或需要逐字引用的材料,对于需要严谨引用的采访记录或合同内容,请同步留存原音频及未经 AI 改写的初版语音文字逐字对照。
Docker 起步与文件保存
以下命令以已安装 Docker Compose 的环境为前提,运行位置是克隆后的仓库根目录。当前 Dockerfile 使用 Python 3.12,并在镜像中安装 FFmpeg;本机手动部署则按 README 准备 Python、虚拟环境和 FFmpeg。
git clone https://github.com/wendy7756/AI-Video-Transcriber.git
cd AI-Video-Transcriber
cp .env.example .env
docker compose up -d
启动后访问 http://localhost:8000。转录文件和下载的视频放在容器的 /app/temp,Compose 默认注释了卷挂载;需要长期留存时,启用 ./temp:/app/temp,并安排磁盘清理。当前容器已经使用生产模式启动,本机处理长录音可用 python3 start.py --prod 关闭热重载。
不需要摘要的脚本任务还可以使用 CLI 的 --no-llm,跳过优化、翻译与摘要,不要求模型 API Key。例如在已装好依赖并激活虚拟环境后处理已有文字:
python transcribe.py notes.txt --no-llm改源码时从哪里入手
| 文件 | 负责的环节 |
|---|---|
backend/video_processor.py |
链接下载、字幕与原视频处理 |
backend/transcriber.py |
Faster-Whisper 语音识别 |
backend/summarizer.py / backend/translator.py |
文字优化、摘要与翻译 |
static/app.js |
界面交互、任务进度及模型设置 |
二次开发时,先确定要改输入、识别还是模型输出,再进入对应文件。这样能避免把平台下载失败当成识别问题,或为了调整摘要样式去改 Whisper。
模型 API 可能计费,文本会交给所选服务处理。网页模型设置保存在浏览器 localStorage,前端也会把 Key 交给本实例后端发起请求,因此公共电脑和不可信部署都不适合保存自己的密钥。将服务开放给别人使用前,应限制访问并管理上传文件及生成材料的留存。
- 项目仓库与使用说明:
https://github.com/wendy7756/AI-Video-Transcriber - 命令行说明:
https://github.com/wendy7756/AI-Video-Transcriber#agents

暂无评论内容