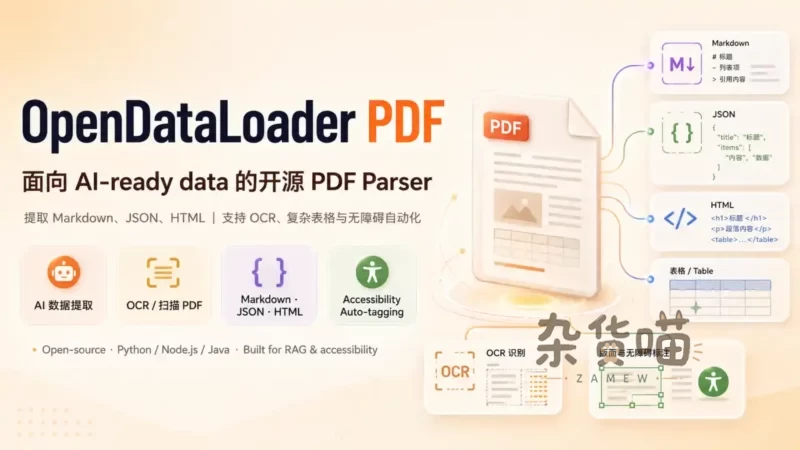


OpenDataLoader PDF 适合解决一个常见卡点:PDF 的文字虽然提取出来了,段落顺序、表格关系和出处位置却丢了。它可以输出 Markdown 和带元素类型、页码、边界框的 JSON,让知识库既有可读正文,也能把答案定位回原页面。项目也能自动生成带结构标签的 Tagged PDF,用于无障碍处理。
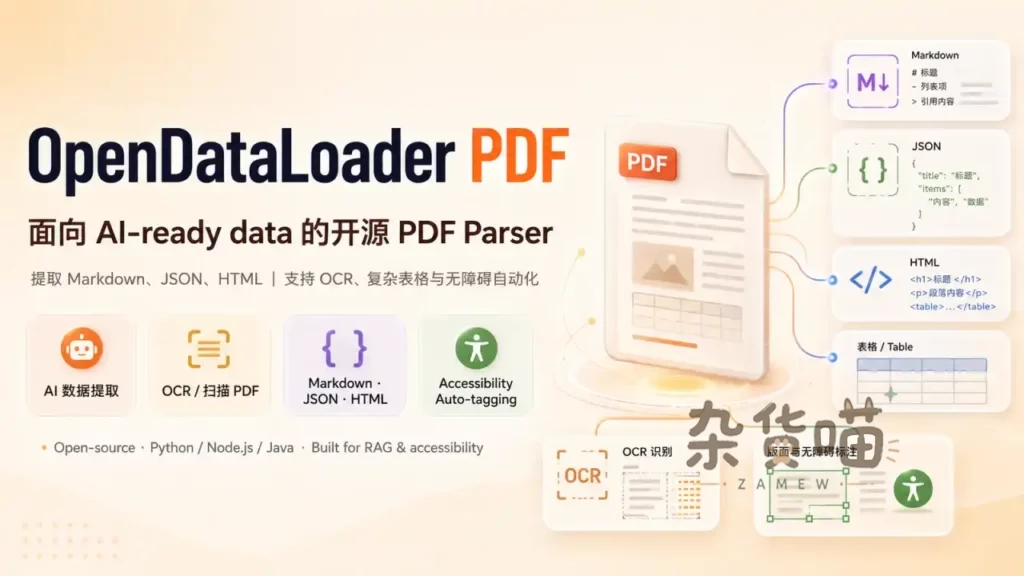
给模型读的正文,与定位出处的数据一起留
多栏论文、报告和手册里,阅读顺序不是简单按坐标从上往下排。标题层级、列表、表格、图注和公式也影响切块。OpenDataLoader PDF 在本地解析中识别这些结构,遇到扫描件、复杂表格和图表等难点时,可使用 Hybrid 后端增强。
| 输出 | 主要用途 | 在流程中的位置 |
|---|---|---|
| Markdown | 可读正文、RAG 切块与模型上下文 | 用于内容整理,仍需检查段落、表格和层级 |
| JSON | 元素类型、页码、坐标、内容及标题级别 | 保留定位信息,供来源引用、页面高亮和后续处理 |
| HTML/Text | 页面展示或纯文本提取 | 按是否需要结构与展示选择 |
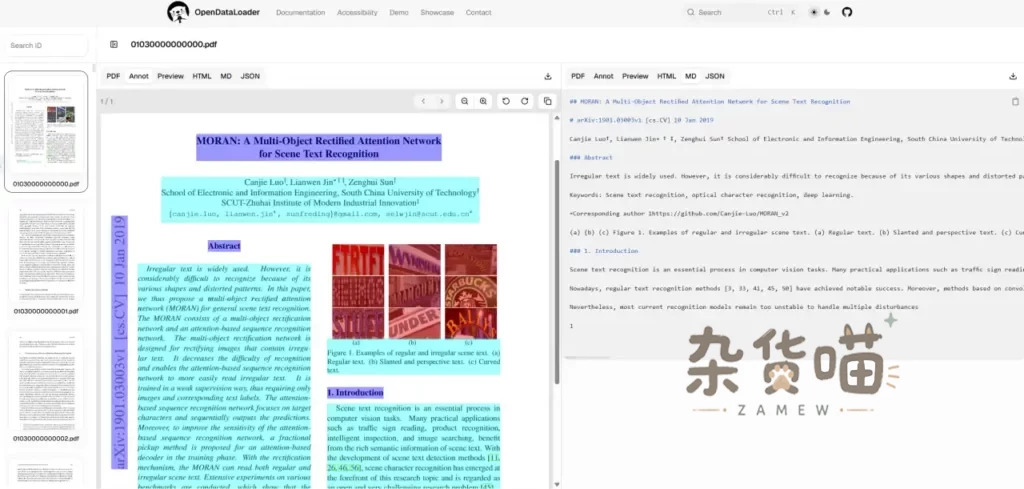
| Annotated PDF | 显示识别区域的标注 PDF | 对照原页查看标题、段落、表格或图片区域是否识别正确 |
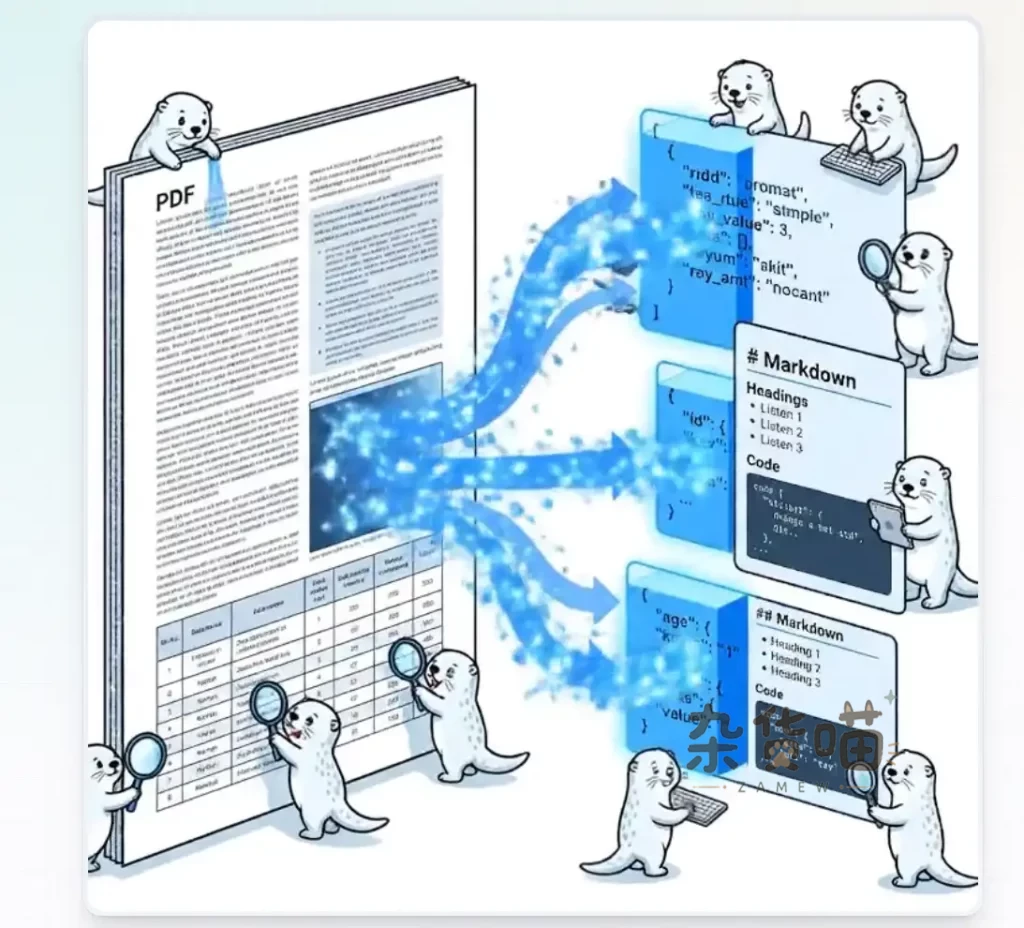
Markdown 和 JSON 不必二选一。前者承担阅读与切块,后者保留来源位置;例如回答引用某张表时,可以把对应文本与页码、区域信息一起存入知识库,而不是在最后只剩下一段无法追溯的文字。项目也提供 LangChain 集成,接入已有文档加载管线时可另行选用。
先跑一批普通 PDF,Java 环境要准备好
Python 路径需要 Python 3.10 及以上和 Java 11 及以上。先执行 java -version 确认 Java 可用,再安装包:
pip install -U opendataloader-pdfimport opendataloader_pdf
opendataloader_pdf.convert(
input_path=["file1.pdf", "file2.pdf", "folder/"],
output_dir="output/",
format="markdown,json"
)多个文件尽量放在一次 convert() 调用里。每次调用会启动 JVM 进程,循环里一个文件调用一次,会重复承担启动开销。这里把文件与目录一起交给转换器,结果写到 output/;命令行同样可以一次处理多个输入:
opendataloader-pdf file1.pdf file2.pdf folder/Node.js 对应 @opendataloader/pdf,Java 对应 Maven 的 org.opendataloader:opendataloader-pdf-core。选择哪个语言入口,取决于现有后端,不必为了用解析器另起一套应用。Node.js 的基础调用是:
npm install @opendataloader/pdfimport { convert } from '@opendataloader/pdf';
await convert(['file1.pdf', 'file2.pdf', 'folder/'], {
outputDir: 'output/',
format: 'markdown,json'
});扫描件和复杂页面,再切到 Hybrid
默认模式适合先处理普通数字 PDF。复杂或无边框表格、扫描页、公式和图片描述需要更强处理时,再安装混合模式依赖;它比默认模式多一个后端服务。
后端保持运行,客户端再发起转换
pip install -U "opendataloader-pdf[hybrid]"
opendataloader-pdf-hybrid --port 5002
在另一个终端发送客户端任务,后端终端不要提前关闭:
opendataloader-pdf --hybrid docling-fast file1.pdf file2.pdf folder/后端可运行在自己的环境里,普通页面与复杂页面按混合流程处理。不要把它笼统写成只要调用一次云端 AI 就能解析所有文件;具体后端位置、模型和参数决定处理路径。
中文扫描件、公式和图表需要不同参数
扫描件无法直接选中文字时,可以在启动后端时强制 OCR。默认 EasyOCR 的简体中文与英文代码分别为 ch_sim 和 en:
opendataloader-pdf-hybrid --port 5002 --force-ocr --ocr-lang "ch_sim,en"若更换 OCR 引擎,语言代码也要按引擎调整,不能照搬 EasyOCR 参数。处理公式时后端开启 --enrich-formula,生成图片或图表描述时开启 --enrich-picture-description;这两类增强还要求客户端使用 --hybrid-mode full。
对于已有良好结构标签的 PDF,可以用 --use-struct-tree 读取原标签。这个选项优先于 Hybrid;两者一起指定时,并不会再调用混合后端。原标签稀疏或有误时,默认解析或 Hybrid 反而可能更合适。
自动生成 Tagged PDF,与 PDF/UA 导出分开看
Tagged PDF 在文件中加入标题、段落、列表、表格和阅读顺序等结构标签,帮助屏幕阅读器理解内容。自动打标签属于开源能力,命令入口是:
opendataloader-pdf --format tagged-pdf file1.pdf file2.pdf folder/PDF/UA-1、PDF/UA-2 导出与 Accessibility Studio 可视化编辑属于企业增强。生成了 Tagged PDF,不等于这份文件已经完成无障碍合规验收。标签关系、阅读顺序和替代文字仍需检查,项目提到的 veraPDF 验证也应按实际输出执行,不能只凭转换成功就认定通过。
先用自己的样本判断,别用一个总分替代验收
- 普通资料:对照 Markdown 的段落顺序,检查页眉页脚、列表与标题是否混入正文。
- 报告与论文:检查 JSON 的页码和坐标,核对表格的行列、图注与公式,再决定是否升级模式。
- 扫描件:选有代表性的清晰页和困难页,检查 OCR 语言、漏字和表格,不必一开始处理整批档案。
- 进入 AI 管线前:保留原文件与定位关系;隐藏、透明或页面外内容的过滤有帮助,但不能保证识别全部恶意指令或替代敏感资料处理要求。
项目方公布了 Hybrid 的提取评测,总体指标 0.907、阅读顺序 0.934、表格 0.928、标题 0.821。这些是其评测集上的结果,不是本文实测,也不能直接解释成你的文件有相同比例会正确。接入前更值得对照的,是自己的文档中那些最容易出错的结构。
当前核心采用 Apache 2.0;2.0 以前版本使用 MPL 2.0。企业增强、第三方依赖和所选模型各有边界,使用旧版本或额外服务时应核对对应许可与处理条件。
- 源码与使用说明:
https://github.com/opendataloader-project/opendataloader-pdf - 官方文档:
https://opendataloader.org/ - Python 包:
https://pypi.org/project/opendataloader-pdf/
暂无评论内容